



Frente
Dados
Banco relacional e NoSQL, S3 e data lake, streaming e BI: guardar, consultar e transformar dado na AWS.
Categorias: Bancos de Dados · Armazenamento · Analytics
47 publicações · atualizado há 18 h
 Redshift ganha transações multi-statement, resolução de conflitos e time travel para IcebergO Amazon Redshift passou a suportar transações com múltiplas instruções, resolução automática de conflitos de escrita e consulta a estados passados (time travel) em tabelas Apache Iceberg, anunciado em 16 de novembro de 2026.
- AWS Backup leva cofre isolado logicamente para o Amazon RDSO AWS Backup estende o recurso de cofre isolado logicamente às instâncias do Amazon RDS, mantendo recovery points imutáveis e fora do alcance de uma conta comprometida.
- AWS Backup passa a suportar cofres logicamente isolados para o Amazon RDSO AWS Backup estende o cofre logicamente isolado (logically air-gapped vault) ao Amazon RDS: backups imutáveis, travados por padrão e prontos para restauração direta entre contas.
Tudo de Dados
Comunidade & EventosRDS e Aurora
RDS criptografado recusando conexão? O problema está na chave KMS, não na rede
Um guia publicado na DEV Community mapeia os quatro pontos onde a permissão entre KMS e IAM quebra silenciosamente num RDS ou Aurora com encryption at rest, derrubando o banco sem tocar em nenhuma Security Group.
Comunidade & EventosS3
Particionamento ruim no S3 encarece cada consulta no Athena
Pastas de data lake cheias de arquivos minúsculos fazem o Athena perder tempo lendo metadados em vez de dados, e isso vira custo real por consulta. O guia mostra como migrar para Apache Iceberg no Glue Data Catalog e compactar os arquivos sem reescrever o pipeline inteiro.
Menos tempo de paradaRDS e Aurora
RDS for Oracle reduz tempo de indisponibilidade em upgrades automáticos e manutenção agendada
A AWS passou a montar os recursos da manutenção até 30 minutos antes da janela abrir, encurtando o downtime de upgrades automáticos de versão menor e de manutenções agendadas no Amazon RDS for Oracle.
Bancos de DadosRDS e Aurora
Como diagnosticar queda de multiplexing no RDS Proxy com CloudWatch Logs Insights
Métrica do CloudWatch mostra QUE o pool de conexões piorou, mas não diz qual aplicação, usuário ou job está causando isso. A AWS publicou as queries de Logs Insights e os alarmes que fecham essa lacuna.
Automação de banco de dadosRDS e Aurora
Aurora PostgreSQL com configuração express agora tem suporte nativo no CloudFormation
A AWS adicionou a propriedade withExpressConfiguration ao recurso AWS::RDS::DBCluster, permitindo criar cluster e instância primária do Aurora PostgreSQL com uma única declaração de template.
Fim do upgrade manualAthena e Glue
AWS Glue passa a atualizar automaticamente a versão do Apache Spark nos jobs
A AWS lançou em 12 de novembro de 2026 o Auto Upgrades do AWS Glue: ao marcar a versão do job como Auto, o runtime Spark migra sozinho para a versão mais recente, com validação de compatibilidade e consentimento antes de cada execução.
Bancos de DadosS3
Migrando de Apache Hudi para Apache Iceberg num data lake em produção
A AWS publicou um guia passo a passo para converter tabelas Hudi em Iceberg usando AWS Glue, Apache XTable e Amazon S3 Tables, sem precisar parar a ingestão nem duplicar todo o armazenamento.
Streaming sem interrupçãoKinesis
Managed Service for Apache Flink ganha snapshots aprimorados para blue/green e recuperação entre regiões
O Amazon Managed Service for Apache Flink passa a oferecer enhanced snapshots: um jeito de capturar, exportar e restaurar o estado de aplicações Flink entre contas e regiões, sem pausar o processamento.
Hardware exclusivo da AWSRDS e Aurora
Amazon RDS for SQL Server passa a suportar instâncias M8id e R8id, com até 384 vCPUs
A AWS liberou as famílias M8id e R8id para o Amazon RDS for SQL Server, com processadores Intel Xeon 6 exclusivos e tempdb automaticamente movido para NVMe local. A região São Paulo ainda não está na lista.
Comunidade & EventosS3
GDPR exige apagar de verdade dados em tabelas Iceberg no S3, não só do SELECT
Um DELETE FROM em uma tabela Apache Iceberg esconde a linha da consulta, mas o arquivo Parquet com o dado pessoal continua no bucket S3. Para GDPR e CCPA, isso não é exclusão: é só um filtro.
Comunidade & EventosS3
Cinco práticas de segurança no Amazon S3 que todo desenvolvedor deveria aplicar
Um guia publicado no AWS Builder Center lista cinco práticas básicas de segurança para quem usa Amazon S3 no dia a dia. O texto é raso sozinho, mas aponta pra armadilhas reais que todo dev que sobe bucket acaba encontrando.
RAG sem infraestruturaS3
Amazon ElastiCache Serverless passa a oferecer busca vetorial, full-text e híbrida
O ElastiCache Serverless para Valkey ganhou busca vetorial, full-text, híbrida e agregações, com latência em microssegundos e sem nenhuma infraestrutura para gerenciar.
Comunidade & EventosRDS e Aurora
Aurora não é um RDS mais rápido, e a diferença aparece sob carga e failover
Aurora e RDS compartilham a mesma API, mas o armazenamento distribuído do Aurora muda failover, custo e comportamento sob carga. Entenda quando cada um compensa de verdade.
Observabilidade sem pipelineAthena e Glue
Athena ganha tabelas de sistema para observabilidade e auditoria de queries
O Amazon Athena passou a gravar automaticamente dados de uso como tabelas Iceberg gerenciadas, lançado em 9 de novembro de 2026. Quem hoje monta pipeline manual de CloudTrail e CloudWatch para auditoria de custo ganha uma tabela SQL pronta.
Comunidade & EventosDynamoDB
DynamoDB importa dados do S3 direto em tabelas existentes sem Lambda
Desde 5 de novembro de 2026, o recurso bulk put items escreve milhões de itens do S3 numa tabela do DynamoDB em produção sem consumir capacidade e com condição por registro, fechando um buraco que antes exigia pipeline próprio com Lambda, Step Functions ou Glue.
Comunidade & EventosRDS e Aurora
Bastion EC2 sob demanda evita porta aberta no acesso ao RDS
Um script publicado por Marcelo Palenzuela no Medium liga a instância EC2 ponte só na hora do acesso, abre um túnel via Systems Manager até o RDS privado e desliga a ponte ao final, sem nunca abrir porta de entrada no Security Group.
Comunidade & EventosAthena e Glue
AWS automatiza migração de tabelas Hive para Iceberg no S3 Tables
Lançado em 4 de novembro de 2026, o recurso gerenciado do Amazon S3 Tables valida, converte e sincroniza tabelas Hive existentes enquanto cargas de produção continuam escrevendo nelas.
Fim do pré-processamentoRedshift
Redshift agora armazena strings de até 16 milhões de bytes dentro do tipo SUPER
Desde 6 de novembro de 2026, colunas SUPER no Amazon Redshift aceitam strings de até 16 milhões de bytes, ante o limite anterior de 65.535 bytes. A mudança exige opt-in por parâmetro de banco e vale para ingestão e para ELT.
Federação Iceberg sem IAM roleAthena e Glue
AWS Glue Data Catalog aceita credenciais vendidas por catálogos Iceberg externos
Na federação com catálogos REST do Apache Iceberg, o Glue Data Catalog passa a usar credenciais temporárias emitidas pelo próprio catálogo externo, reduzindo a necessidade de uma IAM role com acesso amplo ao S3.
Bancos de DadosDynamoDB
DynamoDB ganha bulk put items para importar dados do S3 sem gastar RCU/WCU da tabela
O recurso bulk put items lê arquivos do S3 e grava os itens numa tabela DynamoDB ativa usando capacidade isolada, com relatório de erros e preço por GB em vez de RCU/WCU.
Identidade multi-cloudRDS e Aurora
Amazon RDS for Oracle agora autentica via Kerberos com Active Directory self-managed
RDS for Oracle passa a aceitar autenticação Kerberos ligada direto a um domínio Active Directory self-managed, rodando on-premises, em EC2 ou em outra nuvem, sem precisar do AWS Managed Microsoft AD nem de trust entre domínios.
Ingestão em massaS3
DynamoDB ganha bulk put items para escrever dados do S3 em massa
Recurso novo grava dados de arquivos no Amazon S3 direto em tabelas DynamoDB existentes, sem pipeline customizado e sem estourar capacidade provisionada.
Menos código, mais confiabilidadeS3
AWS SDK for Java 2.x passa a baixar objetos do S3 via URL pré-assinada nativamente
A versão 2.48.0 do AWS SDK for Java 2.x adiciona suporte nativo para baixar objetos do Amazon S3 a partir de uma URL pré-assinada, recuperando retries, métricas e validação de checksum que antes só existiam no fluxo padrão do cliente.
Comunidade & EventosRDS e Aurora
Aurora Backtrack desfaz erro humano em produção sem trocar o endpoint
Um UPDATE sem WHERE que corrompe a tabela inteira não é hipótese: é o tipo de incidente que todo arquiteto de Aurora vai enfrentar um dia. A diferença entre cinco minutos e cinco horas de recuperação está em saber quando usar Backtrack, quando usar Point-in-Time Restore e como lidar com a janela de dados que fica entre os dois.
Disaster recovery em OracleRDS e Aurora
RDS for Oracle agora copia option groups junto no snapshot cross-Region
O parâmetro CopyOptionGroup da API CopyDBSnapshot passou a valer também para cópias entre regiões e contas, eliminando o passo manual de recriar o option group antes de restaurar.
Bancos de DadosRDS e Aurora
Como montar um dashboard de postura do RDS entre contas com ajuda do Kiro
A AWS publicou uma arquitetura baseada em EventBridge e CloudWatch que junta Trusted Advisor, Security Hub, CloudTrail, Config e Health num único painel de postura do RDS. O agente Kiro entra para montar e verificar cada peça contra uma conta real.
Bancos de DadosAthena e GlueMão na massa
Como migrar do BigQuery para um lakehouse aberto na AWS com Apache Iceberg
A AWS publicou uma arquitetura de referência para sair do data warehouse do Google e montar um lakehouse em S3 com Apache Iceberg, onde Athena, Redshift e EMR consultam a mesma cópia do dado.
Preparação para a era pós-quânticaRDS e Aurora
Aurora MySQL 3.14 chega com suporte a troca de chaves TLS pós-quântica
Aurora MySQL 3.14, compatível com MySQL 8.0.46, adiciona troca de chaves TLS pós-quântica (PQ-TLS) para proteger dados em trânsito, além de correções da comunidade MySQL e melhorias específicas da AWS.
Bancos de DadosRDS e Aurora
AWS leva ao MySQL open source otimização de binlog para transações grandes
O BOLT, contribuído pela AWS ao MySQL community em 29 de outubro de 2026, torna o commit de transações grandes no binlog quase instantâneo. Já roda por padrão em todo Aurora MySQL desde a versão 1.22.0; no RDS for MySQL o ganho ainda depende do merge upstream.
Comunidade & EventosDynamoDB
DynamoDB TTL não expira reservas na hora exata: o fix é conditional write
O TTL do DynamoDB promete limpar itens expirados, mas só faz isso dias depois, não no segundo marcado. Um tutorial mostra como construir holds de assentos que expiram de verdade, com conditional writes fazendo o trabalho pesado e o TTL só varrendo o que sobra.
Comunidade & Eventos
AWS Glue federa catálogo com Snowflake Horizon Catalog para tabelas Iceberg
Um tutorial da comunidade DEV detalha a federação de catálogo entre AWS Glue e Snowflake Horizon Catalog e a integração do Amazon Quick com o Snowflake Cortex AI. Para quem desenha arquitetura em produção, o ganho é menos cópia de metadado, mas a conta de governança e custo não desaparece.
Bancos de DadosKinesis
Arquitetura Lambda e Kappa com Spark na AWS: como juntar batch e tempo real sem duplicar pipeline
O Amazon EMR Serverless permite rodar o mesmo Apache Spark tanto para processar o histórico em lote quanto para consumir o stream do Kinesis, o que muda a forma de montar os padrões Lambda e Kappa na prática.
Bancos de DadosRDS e Aurora
Multi-AZ no Amazon RDS: standby isolado ou cluster com duas réplicas de leitura
A documentação do RDS detalha como o Multi-AZ DB cluster, com writer e duas réplicas legíveis em três zonas, se diferencia do Multi-AZ DB instance tradicional, e por que a escolha trava decisões de capacidade, custo e tempo de failover.
Bancos de DadosS3Mão na massa
Como configurar ciclo de vida no Amazon S3: Intelligent-Tiering, Glacier e expiração na prática
Um passo a passo para criar regras de lifecycle no S3 que movem objetos para classes mais baratas e apagam o que não serve mais, sem você precisar lembrar de fazer isso manualmente.
Bancos de DadosDynamoDB
DynamoDB: o banco NoSQL serverless da AWS, e quando ele não é a escolha certa
O DynamoDB sustenta a Amazon.com e a Alexa com latência de milissegundos em qualquer escala, mas essa escala tem preço de modelagem. Veja como ele funciona, para que serve e quando um banco relacional gerenciado cobre melhor o caso de uso.
Bancos de DadosS3Mão na massa
Como criar seu primeiro bucket no Amazon S3 privado por padrão
Um passo a passo completo, pelo console e pela AWS CLI, para criar um bucket no Amazon S3 que já nasce privado, criptografado e pronto para receber dado de verdade.
Bancos de DadosRDS e Aurora
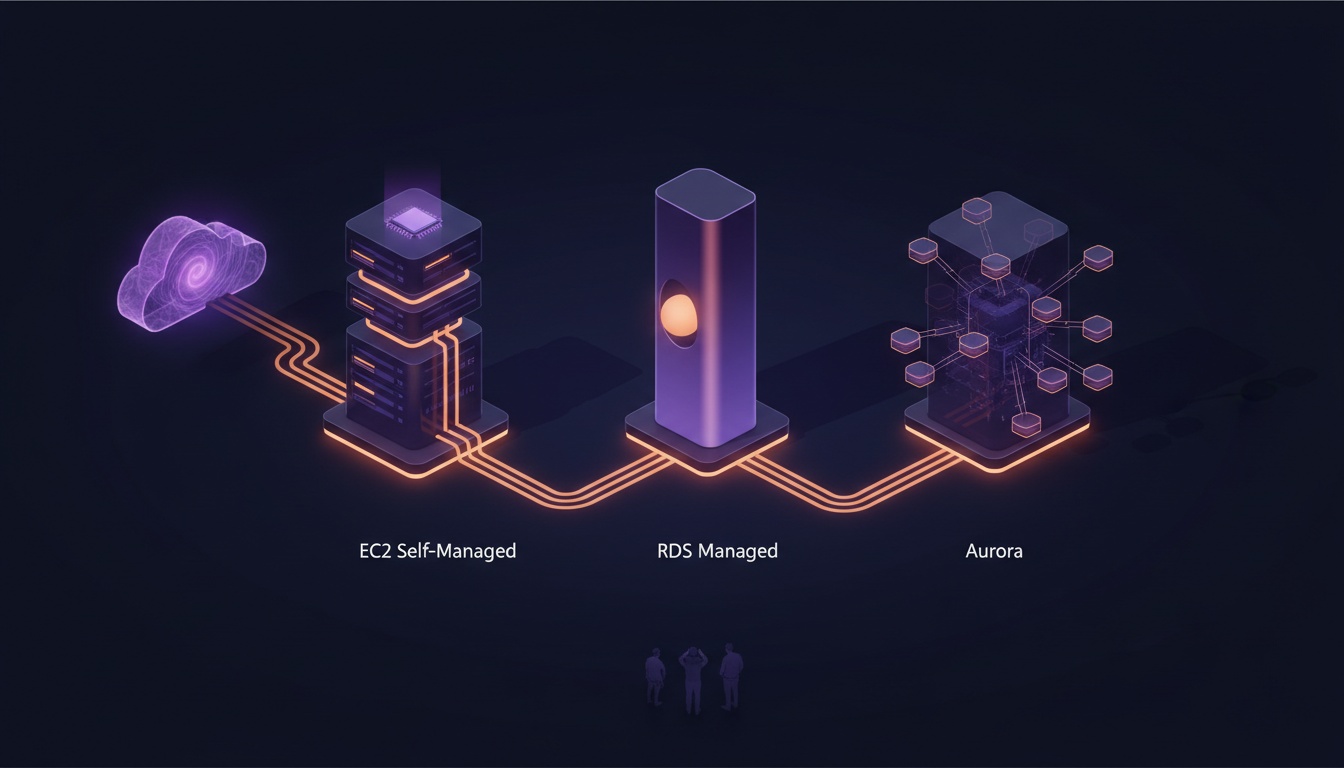
EC2, RDS ou Aurora: como decidir onde rodar seu banco na AWS em 2026
A escolha não é sobre qual banco é
DR mais previsívelRDS e Aurora
RDS for SQL Server passa a aceitar snapshot direto em réplica de leitura
Desde 19 de outubro, dá pra tirar snapshot manual ou automatizado numa réplica de leitura do RDS for SQL Server sem promovê-la antes, o que também acelera a ativação de Multi-AZ em cenários de disaster recovery.
Gestão de réplicas multirregiãoDynamoDB
DynamoDB global tables agora permitem desassociar uma réplica sem apagar os dados
A partir de 20 de outubro de 2026, o DynamoDB deixa remover uma réplica de tabela global sem apagar a tabela nem os dados, útil para sair de setups multiconta ou isolar workloads locais.
Bancos de DadosRDS e Aurora
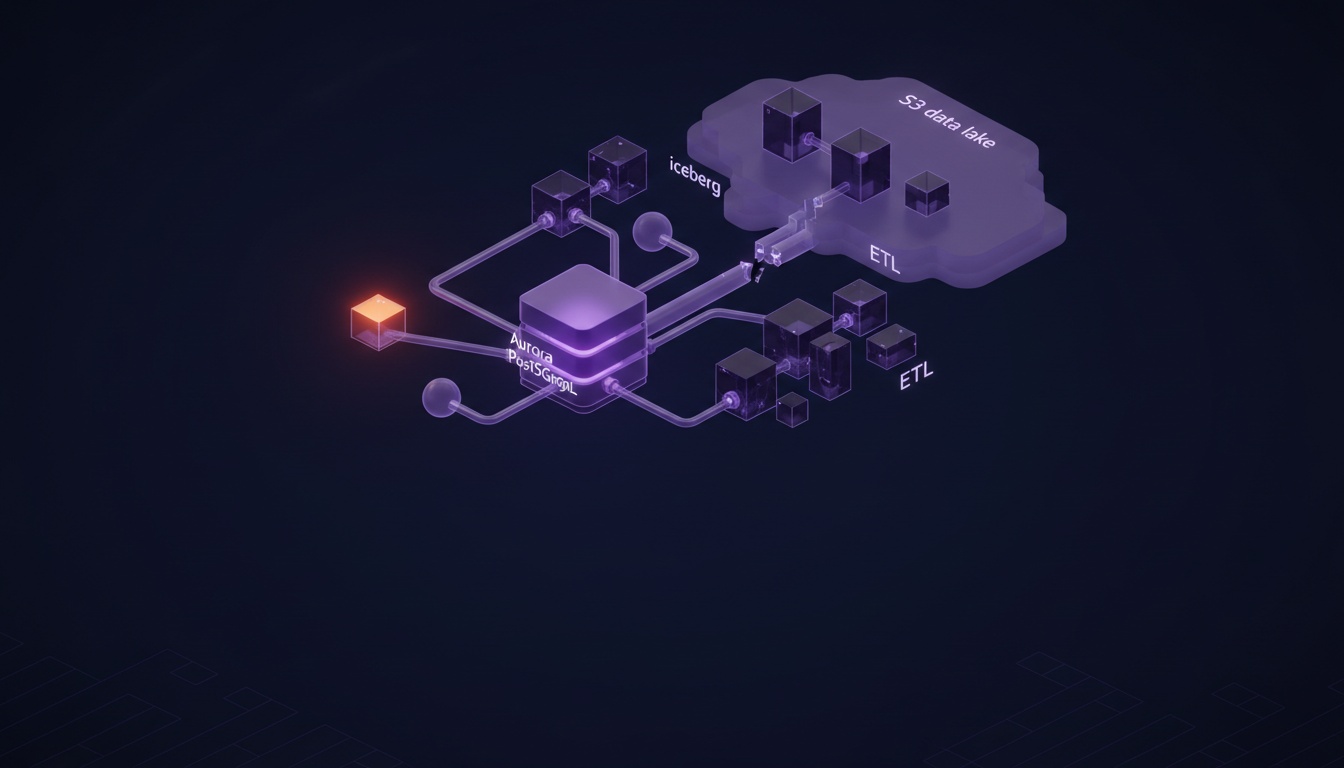
Aurora PostgreSQL passa a consultar Iceberg e Parquet direto no data lake, sem ETL
Nova extensão aurora_analytics embute o motor do DuckDB dentro do Aurora PostgreSQL e permite unir, numa única query, dados operacionais do banco com tabelas Iceberg e arquivos Parquet no S3, sem pipeline de réplica.
Controle fino de streamsDynamoDB
DynamoDB Streams ganha shard iterator AT_TIMESTAMP para retomar leitura a partir de um horário exato
Novo shard iterator AT_TIMESTAMP deixa começar a ler o Streams de qualquer timestamp, sem reprocessar tudo desde o início nem perder registros ao retomar o consumo.
Perguntas frequentes sobre Dados
O que é o Amazon S3?
O S3 é o armazenamento de objetos da AWS: você cria um bucket numa região e guarda arquivos (objetos) identificados por uma chave. Ele tem classes de armazenamento para cada padrão de acesso, do S3 Standard ao S3 Glacier Deep Archive, e o S3 Intelligent-Tiering move os dados entre camadas sozinho. A cobrança é pelo que você usa, sem reservar capacidade antes.
Fonte: docs.aws.amazon.com
Meu bucket S3 fica público por padrão?
Não. Buckets e objetos são privados por padrão, e o Block Public Access vem ligado no bucket; a AWS recomenda manter assim, a não ser que você saiba que precisa de acesso público. As ACLs também vêm desativadas por padrão, e o acesso deve ser controlado por bucket policy e políticas do IAM.
Fonte: docs.aws.amazon.com
Se eu usar a região São Paulo, meus dados ficam no Brasil?
No S3, sim: a documentação diz que objetos guardados numa região não saem dela, a menos que você transfira ou replique de forma explícita. A região do bucket é escolhida na criação e não pode ser trocada depois. Outros serviços têm regras próprias (por exemplo, inferência entre regiões no Bedrock), então confira cada um.
Fonte: docs.aws.amazon.com
Qual a diferença entre RDS e Aurora?
O Aurora é um dos motores do Amazon RDS, compatível com MySQL e PostgreSQL, mas com um subsistema de armazenamento distribuído próprio que cresce sozinho até 256 TiB por cluster. A AWS informa até 6 vezes a vazão do MySQL e do PostgreSQL padrão em hardware semelhante. Ele usa o mesmo console e as mesmas APIs do RDS, e dá para migrar do RDS for MySQL ou PostgreSQL por snapshot ou replicação.
Fonte: docs.aws.amazon.com
Quando usar o DynamoDB?
O DynamoDB é um banco NoSQL serverless, de chave-valor e documento, com latência de um dígito de milissegundo em qualquer escala e sem servidor para administrar. Ele não tem JOIN, então pede modelagem desnormalizada pensando nas consultas. Segundo a documentação, em out/2026, a camada sempre gratuita inclui 25 GB de armazenamento e 25 unidades de leitura e 25 de escrita provisionadas.
Fonte: docs.aws.amazon.com
Quanto custa consultar dados no S3 com o Athena?
Nas consultas SQL, o Athena cobra pelo volume de dados lido em cada consulta. Os exemplos da página de preços, em out/2026, usam US$ 5 por TB lido. O mesmo exemplo mostra que comprimir os arquivos e convertê-los para formato colunar, como Parquet, reduz bastante o volume lido e, portanto, a conta.
Fonte: aws.amazon.com
Revisado em 21/out/2026 contra a documentação oficial da AWS.