

Frente
Dados
Banco relacional e NoSQL, S3 e data lake, streaming e BI: guardar, consultar e transformar dado na AWS.
Categorias: Bancos de Dados · Armazenamento · Analytics
13 publicações · atualizado há 2 h
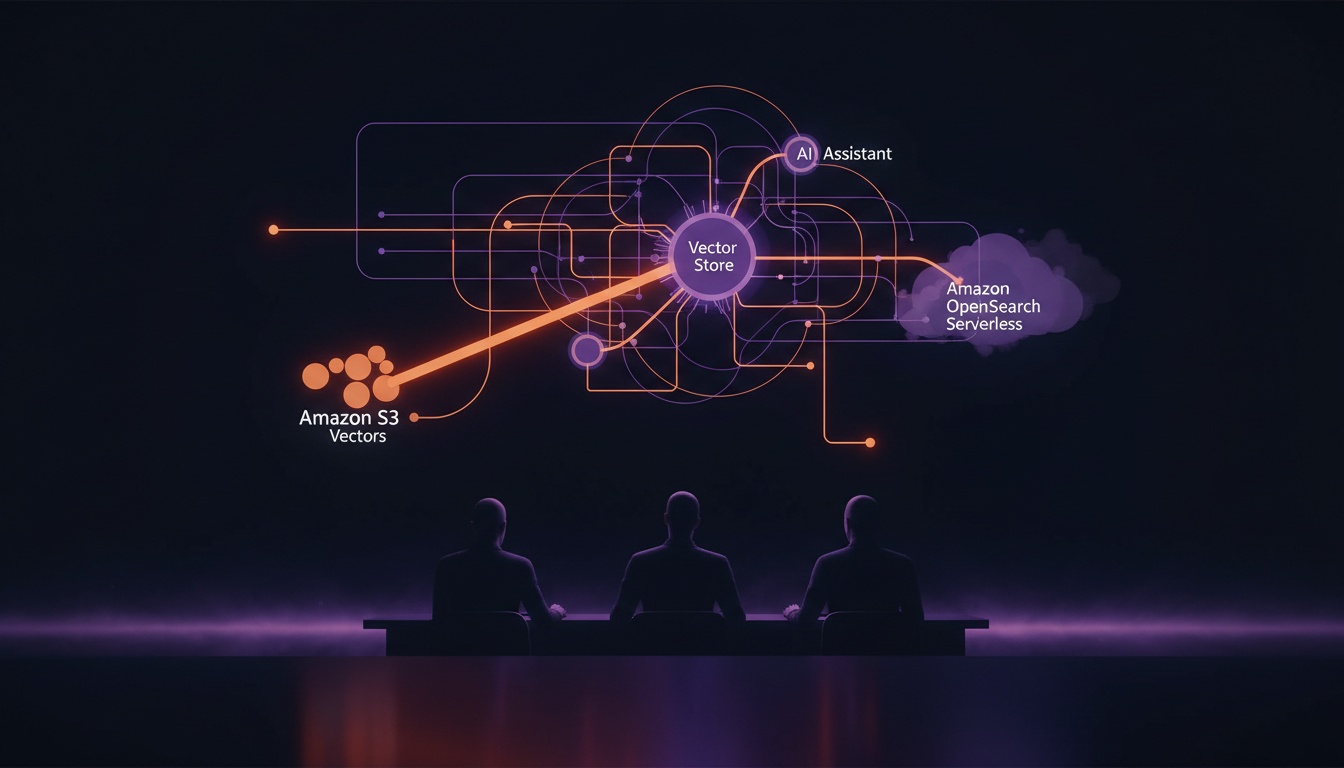 Ânima reduz custo de vector store em 99% com Amazon S3 VectorsA Ânima Educação trocou o Amazon OpenSearch Serverless pelo Amazon S3 Vectors no vector store da assistente IA.RA e cortou a fatura projetada de US$ 30.000 para cerca de US$ 200 por mês, mantendo a qualidade das respostas aos alunos.
- Arquitetura Lambda e Kappa com Spark na AWS: como juntar batch e tempo real sem duplicar pipelineO Amazon EMR Serverless permite rodar o mesmo Apache Spark tanto para processar o histórico em lote quanto para consumir o stream do Kinesis, o que muda a forma de montar os padrões Lambda e Kappa na prática.
- Multi-AZ no Amazon RDS: standby isolado ou cluster com duas réplicas de leituraA documentação do RDS detalha como o Multi-AZ DB cluster, com writer e duas réplicas legíveis em três zonas, se diferencia do Multi-AZ DB instance tradicional, e por que a escolha trava decisões de capacidade, custo e tempo de failover.
Tudo de Dados
Bancos de DadosS3Mão na massa
Como configurar ciclo de vida no Amazon S3: Intelligent-Tiering, Glacier e expiração na prática
Um passo a passo para criar regras de lifecycle no S3 que movem objetos para classes mais baratas e apagam o que não serve mais, sem você precisar lembrar de fazer isso manualmente.
Bancos de DadosDynamoDB
DynamoDB: o banco NoSQL serverless da AWS, e quando ele não é a escolha certa
O DynamoDB sustenta a Amazon.com e a Alexa com latência de milissegundos em qualquer escala, mas essa escala tem preço de modelagem. Veja como ele funciona, para que serve e quando um banco relacional gerenciado cobre melhor o caso de uso.
Bancos de DadosS3Mão na massa
Como criar seu primeiro bucket no Amazon S3 privado por padrão
Um passo a passo completo, pelo console e pela AWS CLI, para criar um bucket no Amazon S3 que já nasce privado, criptografado e pronto para receber dado de verdade.
Bancos de DadosRDS e Aurora
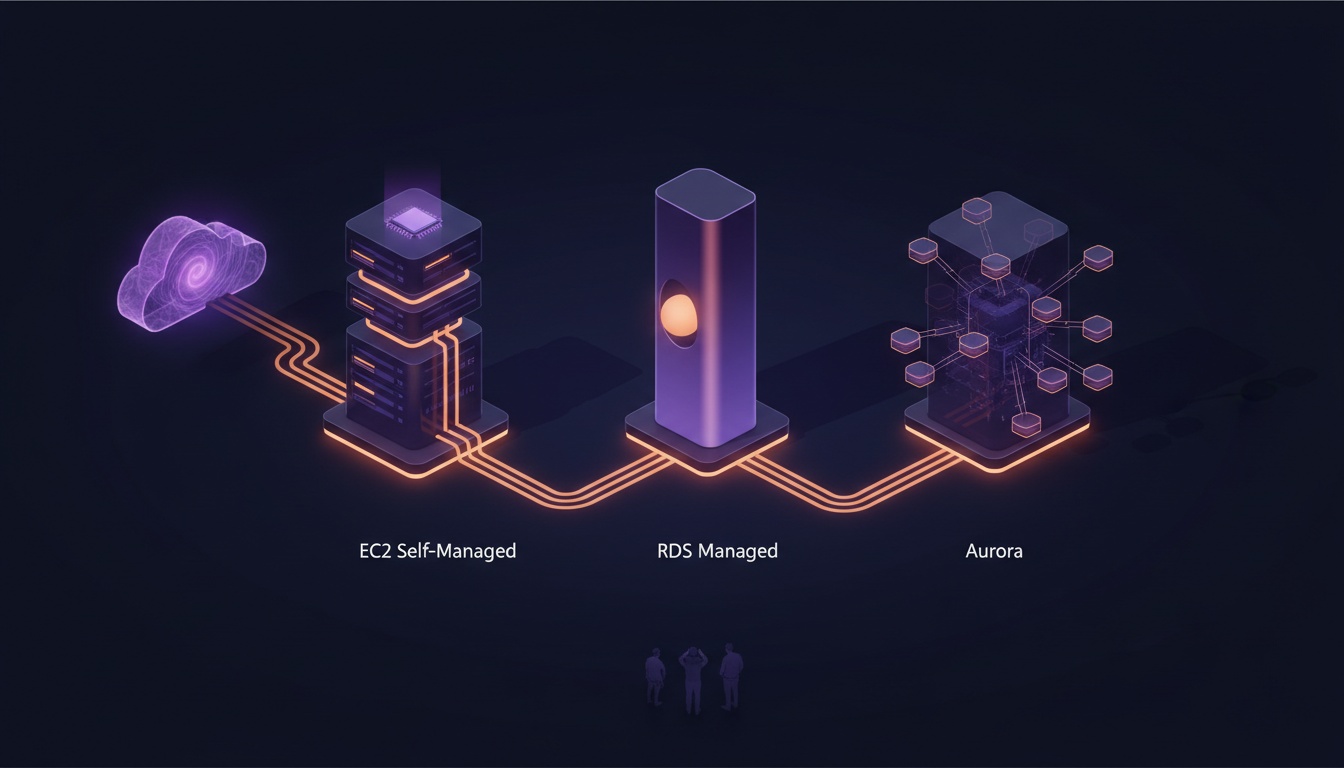
EC2, RDS ou Aurora: como decidir onde rodar seu banco na AWS em 2026
A escolha não é sobre qual banco é
DR mais previsívelRDS e Aurora
RDS for SQL Server passa a aceitar snapshot direto em réplica de leitura
Desde 19 de outubro, dá pra tirar snapshot manual ou automatizado numa réplica de leitura do RDS for SQL Server sem promovê-la antes, o que também acelera a ativação de Multi-AZ em cenários de disaster recovery.
Gestão de réplicas multirregiãoDynamoDB
DynamoDB global tables agora permitem desassociar uma réplica sem apagar os dados
A partir de 20 de outubro de 2026, o DynamoDB deixa remover uma réplica de tabela global sem apagar a tabela nem os dados, útil para sair de setups multiconta ou isolar workloads locais.
Bancos de DadosRDS e Aurora
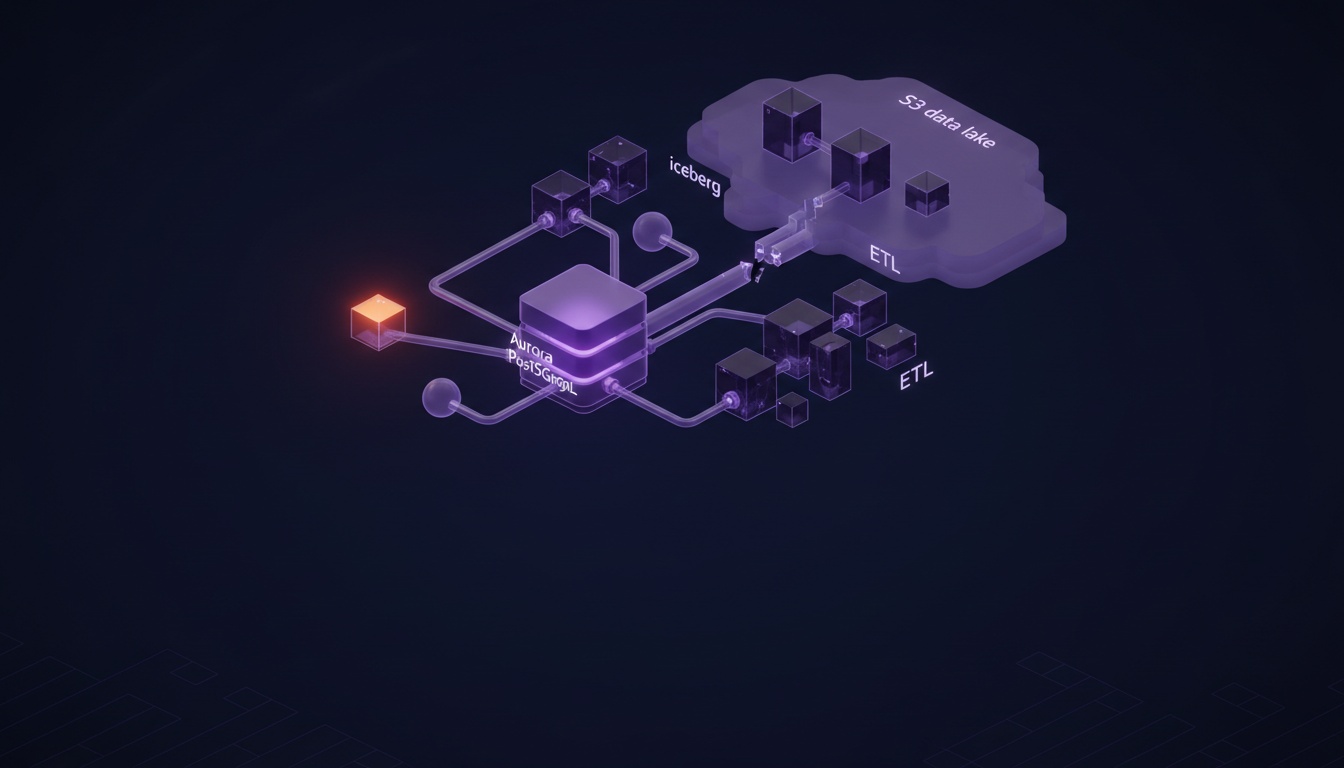
Aurora PostgreSQL passa a consultar Iceberg e Parquet direto no data lake, sem ETL
Nova extensão aurora_analytics embute o motor do DuckDB dentro do Aurora PostgreSQL e permite unir, numa única query, dados operacionais do banco com tabelas Iceberg e arquivos Parquet no S3, sem pipeline de réplica.
Controle fino de streamsDynamoDB
DynamoDB Streams ganha shard iterator AT_TIMESTAMP para retomar leitura a partir de um horário exato
Novo shard iterator AT_TIMESTAMP deixa começar a ler o Streams de qualquer timestamp, sem reprocessar tudo desde o início nem perder registros ao retomar o consumo.
Bancos de DadosS3
S3 Tables passa a suportar todos os tipos de dado do Apache Iceberg V3
O recurso gerenciado da AWS para tabelas Iceberg ganha suporte completo à especificação V3: deletion vectors, row lineage e tipos nativos para dado semiestruturado, geoespacial e timestamp em nanossegundos.
Bancos de DadosAthena e Glue
AWS Glue 6.0 chega com preço 30% menor e suporte completo ao Apache Iceberg v3
Nova versão traz Spark 4.1, Python 3.13 e a especificação Iceberg v3 inteira, com VARIANT shredding, tipos geoespaciais e streaming de baixíssima latência.
Perguntas frequentes sobre Dados
O que é o Amazon S3?
O S3 é o armazenamento de objetos da AWS: você cria um bucket numa região e guarda arquivos (objetos) identificados por uma chave. Ele tem classes de armazenamento para cada padrão de acesso, do S3 Standard ao S3 Glacier Deep Archive, e o S3 Intelligent-Tiering move os dados entre camadas sozinho. A cobrança é pelo que você usa, sem reservar capacidade antes.
Fonte: docs.aws.amazon.com
Meu bucket S3 fica público por padrão?
Não. Buckets e objetos são privados por padrão, e o Block Public Access vem ligado no bucket; a AWS recomenda manter assim, a não ser que você saiba que precisa de acesso público. As ACLs também vêm desativadas por padrão, e o acesso deve ser controlado por bucket policy e políticas do IAM.
Fonte: docs.aws.amazon.com
Se eu usar a região São Paulo, meus dados ficam no Brasil?
No S3, sim: a documentação diz que objetos guardados numa região não saem dela, a menos que você transfira ou replique de forma explícita. A região do bucket é escolhida na criação e não pode ser trocada depois. Outros serviços têm regras próprias (por exemplo, inferência entre regiões no Bedrock), então confira cada um.
Fonte: docs.aws.amazon.com
Qual a diferença entre RDS e Aurora?
O Aurora é um dos motores do Amazon RDS, compatível com MySQL e PostgreSQL, mas com um subsistema de armazenamento distribuído próprio que cresce sozinho até 256 TiB por cluster. A AWS informa até 6 vezes a vazão do MySQL e do PostgreSQL padrão em hardware semelhante. Ele usa o mesmo console e as mesmas APIs do RDS, e dá para migrar do RDS for MySQL ou PostgreSQL por snapshot ou replicação.
Fonte: docs.aws.amazon.com
Quando usar o DynamoDB?
O DynamoDB é um banco NoSQL serverless, de chave-valor e documento, com latência de um dígito de milissegundo em qualquer escala e sem servidor para administrar. Ele não tem JOIN, então pede modelagem desnormalizada pensando nas consultas. Segundo a documentação, em out/2026, a camada sempre gratuita inclui 25 GB de armazenamento e 25 unidades de leitura e 25 de escrita provisionadas.
Fonte: docs.aws.amazon.com
Quanto custa consultar dados no S3 com o Athena?
Nas consultas SQL, o Athena cobra pelo volume de dados lido em cada consulta. Os exemplos da página de preços, em out/2026, usam US$ 5 por TB lido. O mesmo exemplo mostra que comprimir os arquivos e convertê-los para formato colunar, como Parquet, reduz bastante o volume lido e, portanto, a conta.
Fonte: aws.amazon.com
Revisado em 21/out/2026 contra a documentação oficial da AWS.